1
 →

Open-source AI video localization and dubbing for YouTube/Bilibili: speech recognition, subtitle translation, voice cloning, audio mixing and rendering. 开源 AI 视频翻译配音工具。
liuzhao1225/YouDub-webui is an open-source project on GitHub, mainly written in Python. Open-source AI video localization and dubbing for YouTube/Bilibili: speech recognition, subtitle translation, voice cloning, audio mixing and rendering. It currently holds 5,485 stars and 0 forks with 0 open issues, and was last pushed on an unknown date (repository created unknown).
AI Homed tracks it on the AI Audio Projects board and on the AI AI Audio Projects list.
QQ 交流群:618246010
一个被真实创作者工作流验证过的开源视频本地化工具。
YouDub WebUI 可以把单个 YouTube、Bilibili 或本地视频转换成目标语言版本:导入视频、识别并翻译内容,再按任务选择输出保留原音的硬字幕视频、无硬字幕的配音视频,或同时包含硬字幕与配音的视频。配音模式还会分离人声与背景音、生成配音并完成混音,最终视频可在网页中播放和下载。
核心成熟场景是 YouTube 英文 -> 中文配音;同时已经支持 Bilibili 中文 -> 英文配音,并接入本地视频 日文 -> 中文配音。日译中方向已通过自动化参数链路和回归测试,尚未使用真实日语媒体完成模型效果验收。
English README: README.en.md · 作者:刘朝 Zhao Liu(GitHub @liuzhao1225,Bilibili 黑纹白斑马)
作者的 B 站频道:黑纹白斑马(粉丝 100 万+,视频 2 万+,累计播放 6.8 亿+)的全站作品均使用 YouDub WebUI 自动翻译配音,覆盖科技、游戏、科普、动物、历史等题材。
这不是一个只跑过 demo 的玩具项目。YouDub WebUI 的目标很明确:让个人创作者、开发者和小团队能够在本地掌控一条完整的视频本地化流水线,并且保留足够简单的架构,方便理解、调试和二次开发。
下面两组样例均由本项目真实生成,可以在 GitHub 页面直接播放。左侧是原视频,右侧是自动生成的配音版本;配音版包含目标语言语音和字幕,同时保留原视频的背景音乐与音效。
原视频链接 · YouTube Shorts · 英文 -> 中文
| 原始英文 | 中文配音版 |
|---|---|
|
https://github.com/user-attachments/assets/befd11ca-e720-4faa-b4e0-d89bfe73df87 |
https://github.com/user-attachments/assets/bf01f912-eec8-4e0d-8698-0f69283a73e7 |
原视频链接 · YouTube 横屏长视频 · 英文 -> 中文 · 下方为开头 40 秒切片,完整版可在 demo-assets Release 下载
| 原始英文 | 中文配音版 |
|---|---|
|
https://github.com/user-attachments/assets/bd02936f-cf3c-4e4b-85b5-0410d38f69f5 |
https://github.com/user-attachments/assets/158de60a-7de4-4ddf-b3d8-478d0423aee6 |
已验证和推荐的运行方式:
DEVICE=cpu 可以运行部分流程,但完整转写、分离、TTS 会非常慢;DEVICE=mps 会让 Whisper 自动退回 CPU 以避开 MPS float64 限制。PATH 中可用。平台注意事项:
.venv\Scripts\...,不要照抄 .venv/bin/...。.venv/bin/...。py -0p(Windows)或 python3.12 --version(macOS/Linux)的结果。.env。# Windows PowerShell(任选你本机已有的包管理器)
winget install Gyan.FFmpeg.Shared
winget install OpenJS.NodeJS.LTS
Windows 必须安装 FFmpeg 的 shared/full-shared 版本。进入该版本的 bin 目录后执行以下检查;av*.dll 至少应列出 avcodec-.dll、avformat-.dll 和 avutil-.dll。只有 ffmpeg.exe、ffplay.exe、ffprobe.exe 且没有 av.dll 的目录属于静态构建,TorchCodec 无法使用它提供运行库。
$ffmpegBin = "C:\path\to\ffmpeg\bin"
Get-ChildItem "$ffmpegBin\av*.dll"
& "$ffmpegBin\ffmpeg.exe" -version
& "$ffmpegBin\ffprobe.exe" -version
记下通过检查的 bin 目录;在第 4 步创建 .env 后填入该实际路径。Python 3.8+ 的 DLL 加载规则需要应用显式注册搜索目录;单独修改 PATH 无法保证 TorchCodec 找到这些 DLL。YouDub 启动时会读取 FFMPEG_PATH,检查同目录的 av*.dll,并通过 os.add_dll_directory() 注册该目录。配置错误会在启动阶段直接给出原因。
# Ubuntu / Debian / WSL2
sudo apt update
sudo apt install -y ffmpeg nodejs npm
# macOS(Homebrew)
brew install ffmpeg node
如果你的系统包管理器无法提供 Python 3.12,建议从 Python 官网、pyenv、conda/mamba 或发行版推荐方式安装;关键是后续创建虚拟环境时确认使用的是 3.12。
Windows PowerShell、macOS 和 Linux 通用:
git clone https://github.com/liuzhao1225/YouDub-webui.git
cd YouDub-webui
git submodule update --init --recursive
Demucs 以源码子模块引入,请不要跳过 git submodule update。
Python 依赖:
py -3.12 -m venv .venv
.\.venv\Scripts\python.exe -m pip install -U pip
.\.venv\Scripts\pip.exe install -i https://mirrors.aliyun.com/pypi/simple/ -r requirements.txt
前端依赖:
Push-Location apps/web
npm ci --registry=https://registry.npmmirror.com
Pop-Location
Python 依赖:
python3.12 -m venv .venv
.venv/bin/python -m pip install -U pip
.venv/bin/pip install -i https://mirrors.aliyun.com/pypi/simple/ -r requirements.txt
前端依赖:
(cd apps/web && npm ci --registry=https://registry.npmmirror.com)
如果 Aliyun 镜像中某个 Python 包暂时不可用,再单独对失败的包使用 Tsinghua 源重试;不要把多个镜像混在同一条 resolver 命令里。
如果要用 NVIDIA GPU 跑 Whisper、Demucs 或 VoxCPM,请在安装 requirements.txt 之前先安装 CUDA 版 PyTorch:
Windows PowerShell:
.\.venv\Scripts\pip.exe install -r requirements-pytorch-cu128.txt
Linux / WSL2:
.venv/bin/pip install -r requirements-pytorch-cu128.txt
requirements-pytorch-cu128.txt 默认使用 PyTorch 的 cu128 wheel 源。不同 NVIDIA 驱动或 CUDA 环境可能需要不同的 PyTorch CUDA 版本,请按 PyTorch 官方安装页 选择匹配命令。CPU 用户和 macOS 用户不需要执行这一步;如果没有安装 CUDA 版 PyTorch,请在 .env 中设置 DEVICE=cpu。
Windows 上 VoxCPM 的 torch.compile 加速需要 Triton。如果启动时出现 Warning: torch.compile disabled - triton is not installed,VoxCPM 仍可正常工作,但 TTS 会使用较慢的未编译路径(Issue #127 的 Windows 环境实测约慢 2 倍)。Windows CUDA 用户可选择安装社区维护的 triton-windows:
.\.venv\Scripts\pip.exe install -U triton-windows
triton-windows 未纳入默认依赖。安装前请按其项目文档选择与当前 PyTorch 版本匹配的 Triton 版本。
安装后可以验证 CUDA 是否真的可用:
.venv/bin/python -c "import torch; print(torch.__version__, torch.version.cuda, torch.cuda.is_available())"
Windows PowerShell:
Copy-Item env.txt.example .env
macOS / Linux / WSL2:
cp env.txt.example .env
应用运行时读取 .env。不要提交 API key、Cookie、下载视频或生成产物。
Windows 用户把第 1 步确认过的 shared/full-shared FFmpeg 实际路径写入刚创建的 .env:
FFMPEG_PATH=C:/path/to/ffmpeg/bin/ffmpeg.exe
FFPROBE_PATH=C:/path/to/ffmpeg/bin/ffprobe.exe
后端默认强制认证;YOUDUB_AUTH_PASSWORD_HASH 未配置时会拒绝启动。请在本机交互式输入访问密码并生成 Argon2id 哈希,命令不会把明文密码写入 shell 历史:
Windows PowerShell:
.\.venv\Scripts\python.exe -c "from getpass import getpass; from pwdlib import PasswordHash; print(PasswordHash.recommended().hash(getpass('YouDub password: ')))"
macOS / Linux / WSL2:
.venv/bin/python -c "from getpass import getpass; from pwdlib import PasswordHash; print(PasswordHash.recommended().hash(getpass('YouDub password: ')))"
把输出的整行哈希填入 .env 的 YOUDUB_AUTH_PASSWORD_HASH。不要填写明文密码,也不要把真实哈希提交到 Git。
常用环境变量:
| 变量 | 说明 |
| --- | --- |
| WORKFOLDER | 每个任务的媒体、分段音频和中间产物目录。 |
| MODEL_CACHE_DIR | ModelScope 模型缓存目录,默认用于 VoxCPM2。 |
| YOUDUB_AUTH_PASSWORD_HASH | 必填的登录密码 Argon2id 哈希;不接受明文密码。 |
| YOUDUB_AUTH_SESSION_TTL_SECONDS | 登录会话绝对有效期,默认 604800 秒(7 天)。 |
| YOUDUB_AUTH_COOKIE_SECURE | HTTPS 部署必须设为 true;仅可信的本机 HTTP 开发可设为 false。 |
| YOUDUB_AUTH_COOKIE_SAMESITE | 会话 Cookie 的 SameSite 策略,可选 lax 或 strict;同源代理部署建议 strict。 |
| DEVICE | 模型运行设备,例如 auto、cuda、cuda:0、mps、mps:0 或 cpu;auto 按 CUDA、MPS、CPU 顺序选择。 |
| DEMUCS_DEVICE / WHISPER_DEVICE | 可选组件级设备覆盖;留空时使用 DEVICE。Whisper 选择 MPS 时会退回 CPU,因为词级时间戳对齐依赖 MPS 不支持的 float64 DTW。 |
| DEMUCS_CHUNK_SECONDS | 人声分离的分块长度,必须为正整数,默认 600(10 分钟)。内存峰值由单个“分块 + 10 秒上下文”的推理和两份 10 秒 overlap tail 决定;每块写出后,完整输入与输出张量会在下一块推理前释放,跨块只保留两份 tail,内存不会随视频总长或分块数累积。默认窗口约 2.8 GiB 仅作参考,实际峰值还取决于模型、shifts、设备和底层库。首音轨以 float32 解码:mono 复制为双声道,双声道及以上只取前两个声道。临时输入使用 FFmpeg WAV -rf64 auto,超过 RIFF 上限时自动切换 RF64;两份 float32 stem 和两份最终 PCM16 输出固定使用 RF64,消除普通 WAV 的 4 GiB 边界。临时字节数约为“时长秒 × 采样率 × 声道数 × (4 + 4 × 2)”;按 44.1 kHz 双声道估算为 3.55 GiB/小时,写入最终输出时还需 1.18 GiB/小时,建议至少预留 4.73 GiB/小时。临时文件在成功或失败后都会清理。 |
| RELEASE_GPU_MEMORY_AFTER_STAGE | 默认 true。Demucs、Whisper、VoxCPM 阶段结束后释放模型引用和可用的 CUDA/MPS 缓存,并在任务结束时再次清理。单线程流水线在同一任务中不会再次使用这些模型;设为 false 可保留跨任务模型缓存、减少重新加载耗时,同时会增加显存持续占用和 OOM 风险。接受 1/0、true/false、yes/no、on/off。 |
| FFMPEG_PATH / FFPROBE_PATH | 可选的媒体程序完整路径;Windows 上使用 TorchCodec 时,FFMPEG_PATH 必须指向 shared/full-shared 构建。 |
| OPENAI_BASE_URL | OpenAI 兼容 API 地址,例如 https://api.openai.com/v1。 |
| OPENAI_API_KEY | 翻译阶段使用的 API key。 |
| OPENAI_MODEL | 翻译阶段使用的 Chat Completions 模型。 |
| OPENAI_TRANSLATE_CONCURRENCY | 翻译阶段的并发请求数,默认 50。 |
| LOCAL_UPLOAD_MAX_BYTES | 本地视频上传大小上限,默认 4 GiB。 |
| LOCAL_SUBTITLE_MAX_BYTES | 可选本地 SRT 字幕上传大小上限,默认 20 MiB。 |
| YTDLP_PROXY_PORT | yt-dlp 使用的本机代理端口,例如 7890。 |
| HTTP_PROXY / ALL_PROXY | 未在 UI 中设置代理端口时,yt-dlp 可读取 HTTP_PROXY;HTTPX/OpenAI SDK 也会读取这些环境代理。 |
| NO_PROXY | 逗号分隔的代理绕过列表;使用本地 OpenAI 兼容服务时建议包含 localhost,127.0.0.1,::1,避免本地请求绕行系统代理。 |
| VOXCPM_MODEL / VOXCPM_MODEL_DIR | VoxCPM2 的 ModelScope 模型名或本地模型目录;VoxCPM 当前由上游包内部选择 CUDA/MPS/CPU,任务日志会显示为 voxcpm=library-auto。 |
| VOXCPM_LOAD_DENOISER / VOXCPM_CFG_VALUE / VOXCPM_INFERENCE_TIMESTEPS / VOXCPM_MIN_REFERENCE_MS | VoxCPM2 推理参数。 |
| CORS_ALLOW_ORIGINS / CORS_ALLOW_ORIGIN_REGEX | 显式允许的跨源前端来源;不能使用 *。同源 Next 代理不需要配置。 |
Demucs 分离结果采用同目录 pending 发布:handler 每次实际执行时先删除旧 final 和遗留 pending,再完整生成 .audio_vocals.pending.wav 与 .audio_bgm.pending.wav;两份文件都关闭写完后,才分别原子替换 audio_vocals.wav 与 audio_bgm.wav。普通异常会删除 pending 和已经发布的单份 final。SIGKILL 或掉电可能留下 pending 或单份 final,failed/running stage 再次恢复时会先清理并完整重算。真正 succeeded 的 stage 由 PipelineRunner 根据 stage 元数据恢复,不会再次调用 handler。
默认 CORS 只允许 localhost、127.0.0.1 和 ::1 的 :3000。推荐始终使用 Next.js 同源 /api 代理;如果浏览器确实直连不同 origin 的后端,必须把完整、可信的 origin 追加到 CORS_ALLOW_ORIGINS,例如 https://youdub.example.com。CORS 不是认证或 CSRF 防护,后端仍会校验 HttpOnly 会话 Cookie 和每会话 CSRF token。
后端:
.\.venv\Scripts\uvicorn.exe backend.app.main:app --reload --host 0.0.0.0 --port 8000
前端:
npm --prefix apps/web run dev -- --hostname 0.0.0.0 --port 3000
后端:
.venv/bin/uvicorn backend.app.main:app --reload --host 0.0.0.0 --port 8000
前端:
npm --prefix apps/web run dev -- --hostname 0.0.0.0 --port 3000
前端默认通过同源 /api/... 请求访问后端,并由 Next.js 代理到 http://127.0.0.1:8000。如果后端不在本机 8000 端口,启动前端时设置 NEXT_SERVER_API_BASE_URL,例如:
NEXT_SERVER_API_BASE_URL=http://192.168.1.10:8000 npm --prefix apps/web run dev -- --hostname 0.0.0.0 --port 3000
打开:
http://localhost:3000
如果从局域网、WSL2 或远程机器访问,浏览器里使用运行前端机器的实际 IP 或主机名,例如 http://192.168.1.20:3000。后端默认监听 0.0.0.0:8000,前端默认监听 0.0.0.0:3000。
浏览器应始终访问前端地址,由 Next.js 转发 /api;不要把认证信息放进 NEXT_PUBLIC_*、URL query 或前端存储。通过局域网或公网访问时,请在前端前面配置 HTTPS 反向代理并设置 YOUDUB_AUTH_COOKIE_SECURE=true。明文 HTTP 只适用于可信的本机开发环境。
在 POSIX 系统上,后端会在读取 .env、连接 SQLite 或启动 worker 前永久设置进程 umask 0077。启动迁移只检查文件系统元数据,不读取或改写文件内容,并执行以下策略:
data/、Cookie、日志和 WORKFOLDER 下的目录收紧为 0700,普通文件收紧为 0600。-journal、-wal、-shm sidecar、.env、env.txt、Cookie、上传与新生成产物保持 owner-only。MODEL_CACHE_DIR 根目录必须由 root 或服务账号拥有且不可被其他用户写入;服务账号拥有的缓存根会收紧为 0700。缓存内部不做递归 chmod 或内容校验,因此部署前必须确认已有模型缓存可信。WORKFOLDER 的父目录不允许其他组或用户重命名目录项。该边界防护其他 UID 或不可信组用户,不防同 UID 进程、调试器或 root;更强隔离请使用独立账号、容器或系统服务沙箱。
首次启用或执行权限迁移时,应先停止仍会创建或删除运行时文件的旧实例;如果并行启动因 fail-closed 校验失败,请停止旧实例后重试启动。
Windows 的 chmod/umask 不等价于 NTFS ACL。Windows 部署需由管理员把仓库、.env、env.txt、data 和 WORKFOLDER 的 DACL 限制到服务账号;应用会做兼容性检查,但不能替代正确的 NTFS ACL。真实 .env、env.txt、Cookie、SQLite、data/ 和 workfolder/ 已被 .gitignore 排除,不要强制加入 Git。
1. 使用生成哈希时设置的访问密码登录。
2. 打开右上角 Settings。
3. 粘贴 Netscape 格式 YouTube Cookie。
4. 设置 yt-dlp 代理端口,例如 7890 或 20171。
5. 填写 OpenAI base URL 和 API key。
6. 点击 Get models 拉取模型列表,或手动输入模型名。
7. 按 API 提供商额度调整 Translate concurrency。
8. 回到首页,提交 YouTube URL、Bilibili URL,或上传本地视频。
.srt 字幕;上传后会跳过 Whisper 识别和 OpenAI 翻译,再按所选输出内容使用这份字幕。API key 和 Cookie 会在页面中脱敏显示,后端不会把 Cookie 明文返回给前端。
推荐使用 Chrome 扩展 Get cookies.txt LOCALLY(开源,Cookie 不出本机):
1. 在 Chrome 安装扩展并保持启用。
2. 登录 https://www.youtube.com。
3. 在 youtube.com 页面点击扩展图标,选择 Export -> Netscape,得到 cookies.txt。
4. 把文件内容整段粘贴到 Settings 的 YouTube cookie 输入框。
请只处理你有权下载、转换和发布的视频内容。
YouTube / Bilibili URL
-> yt-dlp 下载单个视频
-> Demucs 分离人声与背景音
-> Whisper 识别语音并输出词级时间戳
-> 句子与时间范围整理
-> OpenAI 兼容 API 预处理全文并逐句并发翻译
-> 按输出内容分支:
- subtitles:保留原音并压制硬字幕
- dubbing:生成并混合目标语言配音,不压制硬字幕
- both:生成并混合配音,同时压制硬字幕
-> FFmpeg 输出最终 mp4
本地视频上传使用同一条后半段流水线,支持英文或日文识别后翻译为中文,以及中文识别后翻译为英文。日译中方向会把 ja 传给 Whisper,并使用专用日译中提示词。若同时上传已翻译 .srt 字幕,系统会从 SRT 生成内部字幕时间轴,跳过 Whisper 与 OpenAI 翻译阶段,再按所选输出内容继续处理。v1 仅支持本地视频搭配 .srt,不支持 URL 任务附加字幕。
workfolder/ 下的会话目录。large-v3-turbo)后端测试:
Windows PowerShell:
.\.venv\Scripts\pytest.exe backend/tests
macOS / Linux / WSL2:
.venv/bin/pytest backend/tests
前端检查:
npm --prefix apps/web run lint
npm --prefix apps/web run build
项目的主要目录:
backend/app/       FastAPI API、任务队列、流水线和模型适配器
backend/tests/     后端单元测试
apps/web/          Next.js WebUI
scripts/           辅助脚本
submodule/demucs/  Demucs 源码子模块
YouDub WebUI 仍然是 MVP,但已经可以支撑真实创作者的日常视频本地化生产。当前优先级是保持最短链路稳定、保持架构简单,并让更多人能跑起来、改得动。
欢迎贡献:
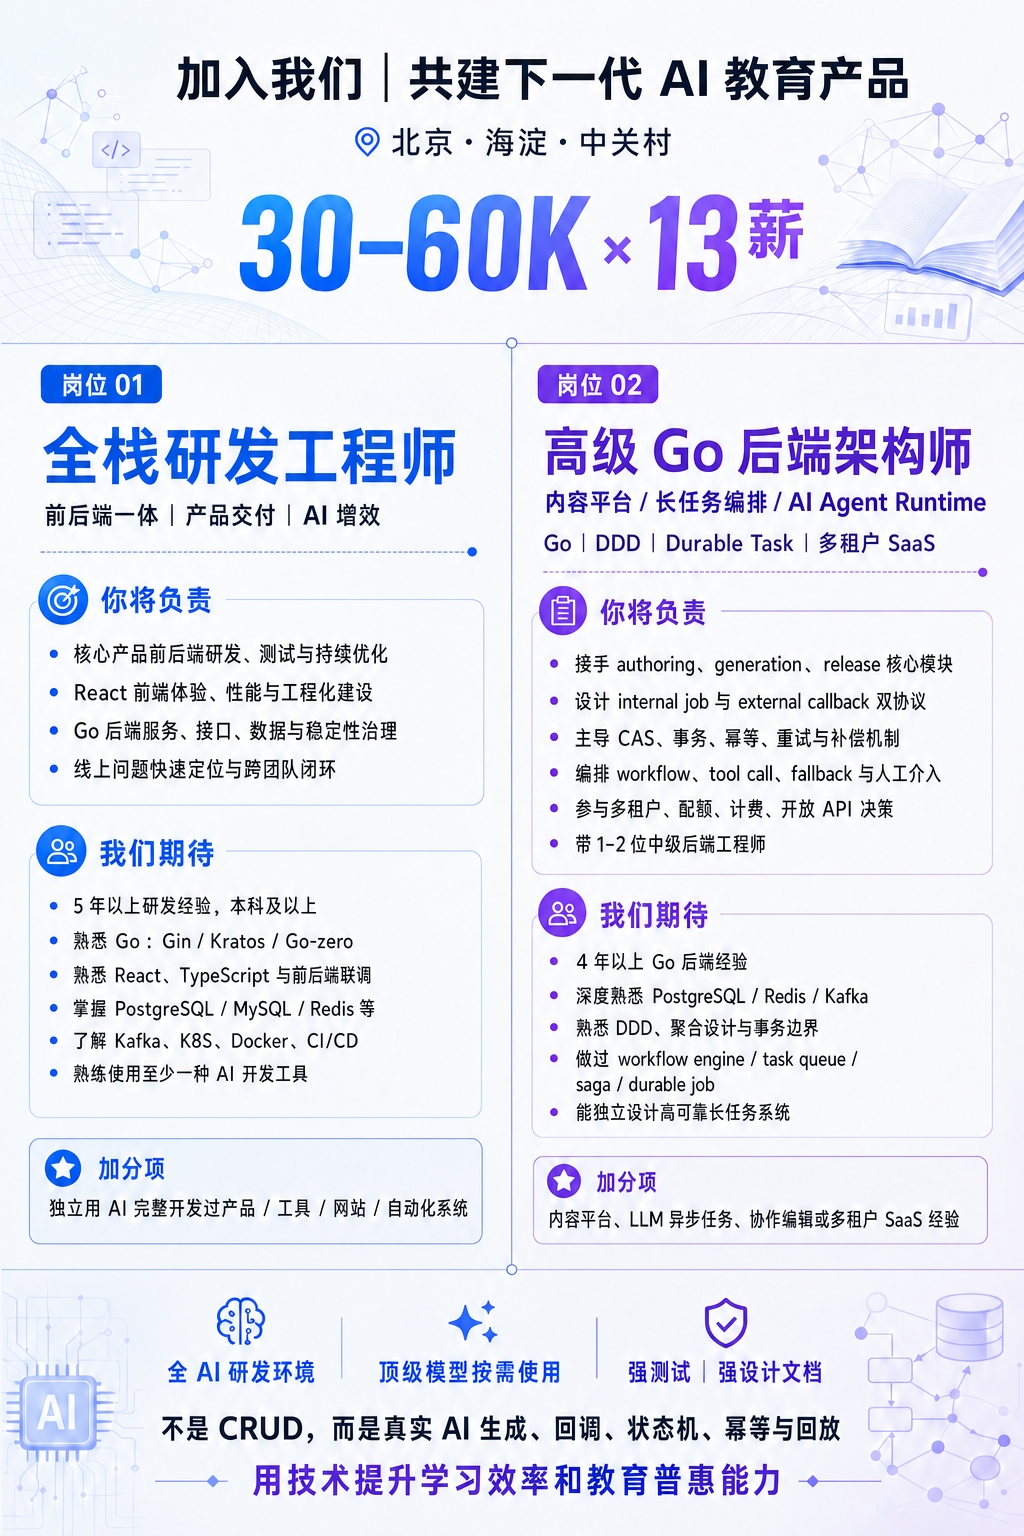
银河智学是一家人工智能教育科技企业,致力于将大模型技术与探究式教学范式深度融合,构建面向 AGI 时代的创新学习体系。
公司官网:xiaoluxue.com
我们正在北京海淀区中关村招聘以下岗位:
QQ 交流群:618246010
本项目使用 Apache License 2.0,详见 LICENSE。
→ →
 →
 →
 →
 →
 →
 →