
1
 →
SAOS-3624/dsh-see-now is an open-source project on GitHub, mainly written in JavaScript. 让 AI 实时看见你的屏幕:按变化量筛选帧、多帧拼进一张图,静止画面几乎不花 token It currently holds 252 stars and 19 forks with 5 open issues, and was last pushed on 2026-11-03 (repository created 2026-11-01).
AI Homed tracks it on the Today's Trending board, currently at rank #82 with 0 new stars today.
AI 不再"听你描述屏幕",而是自己看 —— 而且只传"画面变了"的那几帧。
一个给 DSH 用的实时视觉插件:把你的屏幕(或摄像头 / 视频文件)变成一串按变化量筛选过的画面,压进一张几帧拼成的图,交给模型。
静止的屏幕几乎不花钱;一镜到底的视频按"运动量"给帧;硬切幻灯片每切一次留一帧。
---
Apache License 2.0 —— 随便用。个人、公司内部、闭源产品、SaaS、二次分发都可以, 不需要问我要授权,也不收费。只要保留 LICENSE 和 NOTICE 这两份文件。
如果你觉得它替你省了时间,欢迎扫码打赏 —— 纯自愿,不影响上面任何一个字:
提交 PR 前读一下 CONTRIBUTING.md —— 现在不需要签 CLA 了, 按 Apache-2.0 的规矩来就行。
---
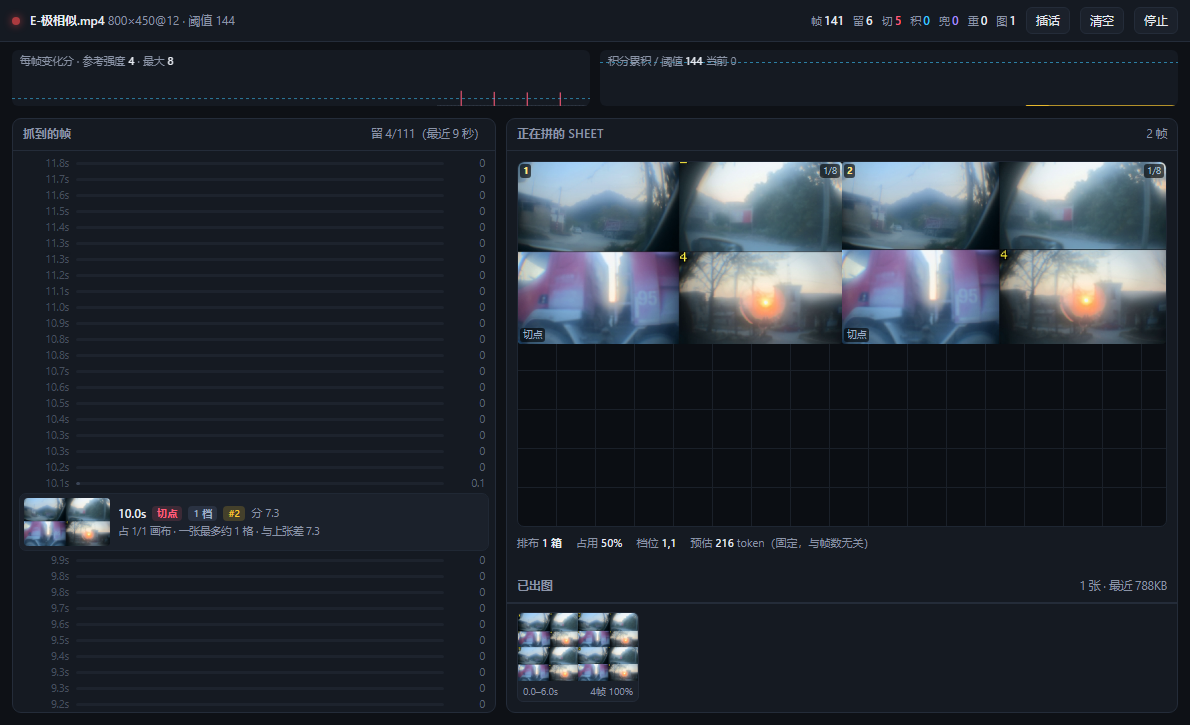
调试窗(开发期用,不在发布包里):左边是抓到的每一帧,留下的带缩略图和格号,没留下的只剩一根分数条;右边是正在拼的那张图,按真实像素位置摆,新帧落格会亮一下,重排时格子会滑动。
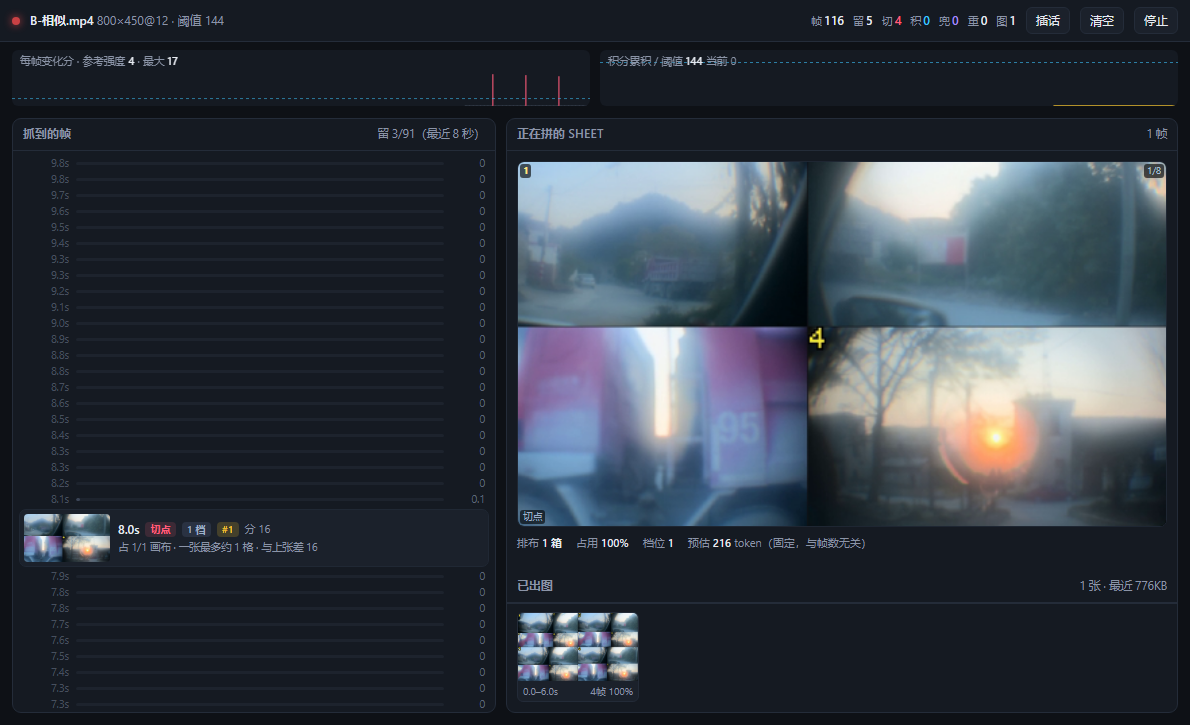
逐场景模式(scene:true):每换一次画面单独出一张满幅图,右下角「已出图」每条都标着 1 帧 100%。
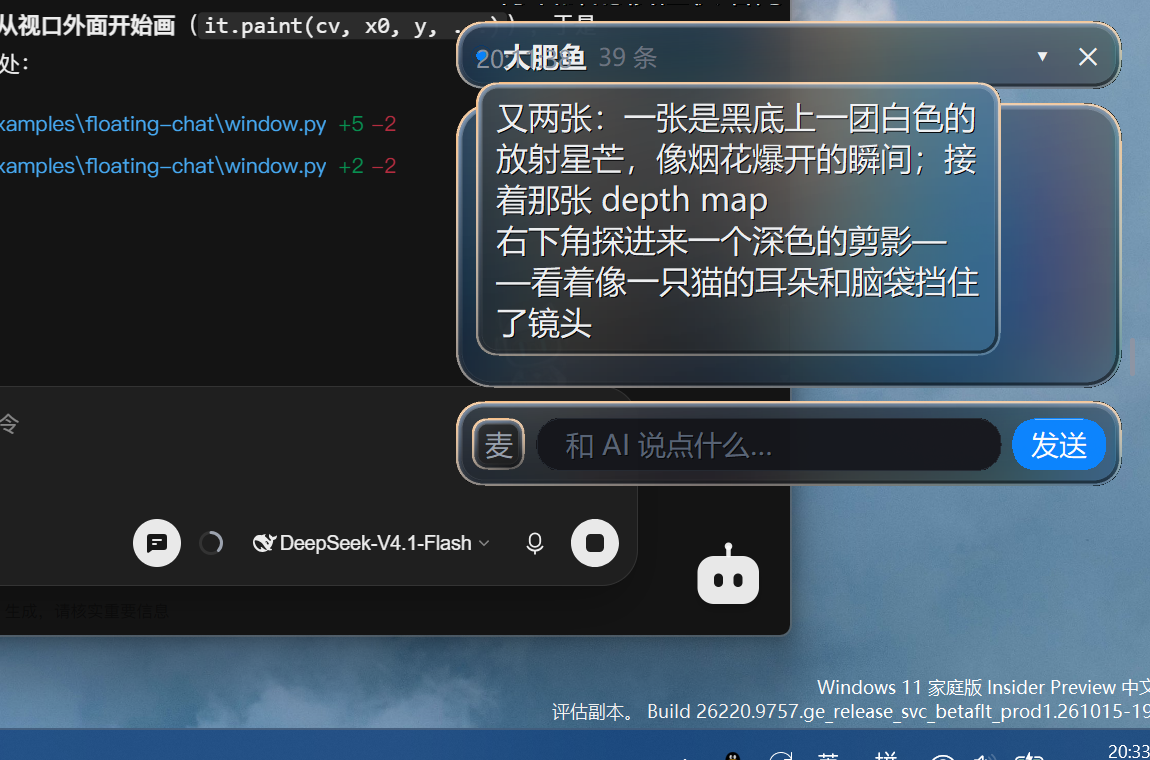
悬浮窗:AI 说的话在这里出现并被念出来(say 是唯一通道)。
---
想让 AI 陪你看屏幕,最直觉的做法是"定时截全屏喂过去"。两个死结:
| 做法 | 问题 | |---|---| | 每 2 秒截一张全屏 | 一分钟 30 张图,全是重复画面,token 直接烧穿 | | 每隔 30 秒截一张 | 中间发生了什么全丢了,AI 只会说"看起来你在用电脑" |
See Now 换了个思路:先判断这一帧值不值得看,再决定传不传。
---
| 场景 | 表现 | |---|---| | 静止屏幕(看文档、发呆) | 几乎不出图。20 秒给一张兜底帧,让你知道"确实没变" | | 滚网页、切窗口 | 变化剧烈 → 留几帧 → 每 15 秒左右给你一张 | | 一镜到底的视频 | 没有切点,靠"积分"攒够一个采样点才出帧 | | 硬切幻灯片(每张停 2 秒) | 每切一次留一帧,6 张照片 → 6 帧 |
成本口径:800×450 一张 ≈ 233 token(按宿主 DeepSeek-V4 的 patch 网格算:14px patch 向上对齐 → 42px 一格 → rows×(cols+1)+2)。
一张图里塞 4 帧还是 8 帧,价格一样 —— 所以"多留一帧"几乎免费,"漏掉一帧"才贵。
插件源码里 SIZES 的旧注释写着 218 token,那是早期按"像素 ÷ 1650"估的,偏低。以 233 为准。
---
已经发布到 npm,用 DSH 自带的 dsh plugin 装(它本质是 profile 维度的 pnpm 包装器 +
插件登记器,会在装前预检 engines/peer、装后自动把 dsh.bundle 写进 profile):
dsh plugin --profile web add dsh-see-now
web 是浏览器里用的那个 profile;桌面版换成 --profile desktop(那个 profile 需要先开过一次桌面端才会被初始化)。see_nowtool-addition 告诉模型多了这个工具)。所以「工具表在会话开头就定死了」
不成立 —— 挂不上多半是没重启,或者装的是旧副本。
dsh plugin --profile web remove dsh-see-nowdsh plugin --profile web update dsh-see-nownpx dsh-see-window # 开窗(已经开着就什么都不做)
npx dsh-see-window --status # 只看它在不在
npx dsh-see-window --force # 杀掉重开
npx dsh-see-window --close # 关掉
git clone https://github.com/SAOS-3624/dsh-see-now.git
cd dsh-see-now
node scripts/install-dev.mjs      # 拷进本机 DSH 的 desktop profile
install-dev 是复制不是软链(Node 解析裸包名要走真实路径,软链会找不到宿主的@deepseek-ai/dsh-tools)。装完同样要重启 DSH。| 平台 | 屏幕引擎 | 要额外做的 |
|---|---|---|
| Windows | ddagrab,不行退 gdigrab(自动探测) | 无 |
| macOS | avfoundation | 系统设置 → 隐私与安全性 → 屏幕录制,勾上跑 DSH 的 App |
| Linux | — | 还没接(要补 x11grab / PipeWire) |
ffmpeg 不用进 PATH:插件会按 DSH_FFMPEG_PATH / FFMPEG_PATH / DSH_FFMPEG_DIR /
~/.dsh/tools/ffmpeg/bin / ~/.dsh/bin 的顺序自己找(DSH 桌面版把 ffmpeg 装在第四个位置)。
然后让模型调:
see_now({ action: "watch" })          // 阻塞到你攒够一张图,然后把图交回来
see_now({ action: "watch", say: "…" }) // 同时说一句话(只有 say 会进悬浮窗、会被念出来)
第一次调用约 1 秒返回当前屏幕;之后每次返回"这段时间里发生的事"。
包本身不依赖 DSH,capture / pipeline / png 都是独立导出的:
import { spawnFrames } from 'dsh-see-now/capture';
import { createPipeline } from 'dsh-see-now/pipeline';
const p = createPipeline({ width: 800, height: 450, fps: 12, queueDepth: 0 });
const run = spawnFrames({
  source: { kind: 'screen' },           // 或 { kind:'file', path:'x.mp4' }
  width: 800, height: 450, fps: 12,
  onFrame: (f) => p.push(f),
});
setInterval(() => {
  const sheet = p.take();               // 一张 PNG + 每帧的时间戳/档位/来源
  if (sheet) require('fs').writeFileSync(sheet-${sheet.at}.png, sheet.png);
}, 200);
---
核心不内置任何 TTS 引擎,只 dynamic import 一个你指定的模块。配好之后,
say 会进悬浮窗并且被念出来;普通回复永远只有字。
// ~/.dsh/voice.json
{ "adapter": "/绝对路径/examples/voice-say-mac.mjs" }
自定义模型:适配器自己的配置走 options,原样交给 attach(api, options) ——
换自己训的模型不用改适配器源码:
// ~/.dsh/voice.json
{ "adapter": "D:/my-voice/index.mjs", "options": { "model": "D:/my/models/xxx" } }
macOS 自带一个:examples/voice-say-mac.mjs,走系统的 say,音色和语速从
~/.dsh/tts.json 读(和 dsh-watch-together 共用同一份):
// ~/.dsh/tts.json
{ "voice": "Tingting", "rate": 185 }
say -v '?' | grep zh_ 可以列出本机所有中文音色(Tingting / Meijia / Sinji / Reed / Rocko…)。
改完不用重启:每次调用工具前都会比对一次配置指纹(适配器路径 + tts.json 内容摘要),
变了就自动卸载重挂,没变就一次读文件的开销。所以改音色、换适配器,下一句就生效。
适配器要自己处理两件事:串行(两个say抢音频设备会像结巴)和spoken上报
(在出声的那一瞬发,不能等念完 —— 展示层是"字跟着声音走"的)。
---
上一节是它说给你听,这一节是它听你在看的东西。
图只能说明画面,说明不了"他们在说什么"。开着这个之后,see_now 的清单里会多一段
台词,时间码和每帧那个 24.1s 是同一个坐标系 —— 模型能把一句话对到某一格画面上。
过去 24.1–45.6 秒的 4 个画面 · 798×462
  1. 24.1s · 400×225 · cut · 2 档
  ...
台词(这段时间里视频里在说的,机器转写,可能有错字/听岔):
  24.4s  评价一个镜头的好坏,一般来说有两个维度
  31.2s  第二个维度是艺术维度
要什么:一条 WASAPI 回环(抓的是"电脑正在放什么",不是麦克风)+ 一个转写服务。
speechToText(SenseVoice),不用配任何东西;~/.dsh/asr.json 里指一个 OpenAI 兼容服务
(和 dsh-video-storyboard 共用同一份配置):
{ "baseUrl": "http://127.0.0.1:8000/v1", "key": "local-key", "model": "paraformer-zh-2024-03-09" }
pip install pyaudiowpatch numpy。不需要装虚拟声卡,也不需要开"立体声混音"。~/.dsh/see-window.json:
{ "listenPython": "C:/Python313/python.exe" }
开销(i9-12900HX / Win11,实测):抓回环 0.3% 单核,转写 3 秒段 130–160ms。 跟画面采集(0.18–0.43 核)比是零头。
延迟("这句话说完" → "模型能读到它"):
| 环节 | 耗时 | 说明 |
|---|---|---|
| 静音判定 | 450ms | 要等这么久才确认"说完了"。这是大头,也是唯一能明显缩短的一项 |
| 写盘 + 扫目录 | 5ms + 平均 100ms | pollMs=200,Python 是写完 .tmp 再 rename,读不到半截 |
| 转写 | 130–250ms | 3 秒段 130ms、10 秒段 400ms |
| 合计 | 约 0.7–0.8 秒 | 从最后一个字到文字可用 |
这不影响实际使用:图本身是攒 15–40 秒才发一张,0.8 秒的转写延迟完全被淹没 —— 台词跟图走, 图覆盖"过去 30 秒",台词也是"过去 30 秒"。真正能感觉到的只有一处:一句话刚说完的那 0.7 秒内 问"它刚才说什么",还拿不到。
要更快就把 createListener({pollMs}) 调小(最低 100 左右,再低只是空转),
或者把 listen.py --silence 从 0.45 降到 0.3 —— 代价是句子更容易被切成两半。
没有或不想用:DSH_SEE_AUDIO=0 关掉;或者干脆不装那个 Python 包。
两种情况都只是没有字幕,看图一切照旧 —— status 里的「听声音」那一行会直说是
缺服务、缺包、还是这台机器抓不到回环:
听声音:在听(宿主 SenseVoice,累计 42 句,最近一句 3s 前)
听声音:没在听 —— 没有能用的 Python(要 pip install pyaudiowpatch numpy)
已知限制:
quiet-until.json(和 mic.py 共用),念的时候整段丢弃 —— 否则 AI 会把自己的话
当成"视频里说的",然后接着聊下去。
| 参数 | 说明 |
|---|---|
| action | watch(默认,阻塞取图)/ peek / start / stop / status / window / region |
| show | 配 action:"window":true 把悬浮窗叫回来,false 藏起来,不传只报状态 |
| region | 只看屏幕上一块:"x,y,w,h"(屏幕物理像素),或 "off" 取消。一般不用手填 —— 说"框这块"让它自己框,见下 |
| say | 唯一能进悬浮窗、能被念出来的通道。普通回复不进气泡,但会被记进小窗的对话记录 |
| quality | low(800×450) / standard / high / ultra。改它会重启采集(~0.6s),并立刻返回当前这一帧 |
| pace | 节奏:calm / normal(默认)/ dense。见下 |
| scene | true = 逐场景模式:一张图只装一个画面、铺满。见下 |
| seconds | watch 的阻塞上限(默认 300,封顶 860)。只是上限,攒够一张就提前返回 |
| minFrames | 少于这么多帧的图就别给我了(省 token) |
| source / path / realtime | 采集源:屏幕 / 摄像头 / 回放一个视频文件 |
region / action:"region")只想让它盯住屏幕上的一个窗口(手机竖屏通话、播放器的画面、某个聊天窗口)时,
不用自己量像素:说一句"框这块",模型会调 see_now({action:"region"}),
屏幕变暗后拖一个框,松手就行。坐标存在 ~/.dsh/see-now/region.json,
之后每次 watch 默认只看这块,region:"off" 取消。
三条边界(插件会如实告诉模型,模型也该如实转述):
pace)| 档 | 换画面门槛 | 最多多久叫醒一次 | 适合 |
|---|---|---|---|
| calm | 20 分 | 30 秒 | 日常挂着,只想知道"大场面变了没" |
| normal(默认) | 12 分 | 15 秒 | 滚网页、切窗口不会每下都留帧 |
| dense | 7 分 | 8 秒 | 幻灯片、逐帧播报 —— 贵,别常开 |
觉得它太吵、太烧钱,就说一句「慢一点 / 省点钱」,模型会传 pace:"calm"。
觉得它漏了、迟钝,就说「不灵敏」,它会传 dense。
scene)打开后每换一次画面单独给你一张满幅图,并且每换一次就叫你一次 —— 用来做"每翻一页说一句这是什么"。
see_now({ scene: true, say: "好,接下来每换一个画面我就说一句" })
它是粘性的,一直生效到 scene:false 或停止。
单帧铺满靠的是 strategy: 'single'(档位固定压到 1),不然场景一密,格子会缩到 1/4、1/9,中间全是灰条。
---
两条判据,缺一不可:
① 切点 —— 这一帧的分数跳得又高又孤立
score ≥ cutAbs(12)                 // 绝对地板:变化够不够大
score > 2.5 × max(1, 前后帧)        // 尖峰:是不是"一下子"
距上一刀 ≥ 0.4 秒                   // 不应期
② 积分 —— 分不高但一直有,攒够才录一帧
need = 4分 × 12fps × 3秒 = 144      // 固定的绝对阈值,不跟着画面一起涨
每帧累加自己的分,累够就录、清零
为什么两个都要:尖峰是相对的,在低分区也会成立。实测缓慢放大(持续运动)有帧 s=13.6、前后邻居只有 1.1/1.3,尖峰判据完全放行 —— 没有绝对地板,它就会被切成一块块。
反过来只有地板也不行:一镜到底的视频每帧 4 分,永远不会"跳"。
---
npm run debug:live                                   # 看屏幕
npm run debug:live -- --source=file --file=x.mp4 --realtime=1
npm run debug:live -- --source=file --file=x.mp4 --scene    # 看逐场景模式
Windows 上可以直接双击 debug/调试窗.cmd,跟着菜单走。
窗口里有三样东西:帧流(每一帧都有一条,留下的带缩略图和格号)、正在拼的 sheet(按真实像素位置摆,新帧落格有动效)、两条曲线(每帧变化分 + 积分累积/阈值)。
代码在 debug/,不进 npm 包、不进插件,只是从外面驱动同一条流水线。
---
采集开销(12fps → 800×450):
| 源 | 首帧 | CPU |
|---|---|---|
| ddagrab(桌面复制 API) | 370ms | 0.28 核 |
| gdigrab(GDI 抓屏) | 310ms | 0.45 核 |
| OBS 虚拟摄像头 | 575ms | 0.13 核 |
| 源 | 首帧 | CPU |
|---|---|---|
| avfoundation 屏幕 | ~700ms | ~0.16 核 |
首帧慢在 AVCaptureSession 冷启动(ffmpeg 进程本身 ~300ms),但稳态比 Windows 两种引擎都省。
像素格式是探针试出来的,不是写死的:屏幕输入不支持默认的 yuv420p,探针按 CPU 从省到费
(nv12 → uyvy422 → bgr0 → 设备默认)试到第一个真能出帧的,然后整个进程记住。
macOS 上有两个坑会伪装成"插件坏了",都写在 src/capture.js 里:
① -framerate 在 avfoundation 屏幕源上不压速(实测 30 帧只用 0.73 秒,≈40fps),
必须靠输出侧 -r 12 把速度压回来 —— 开发时少了这一条,管道被灌出过 240GB 的 raw 文件。
② 没有「屏幕录制」权限时它不报错,exit 0、帧数正常,只是全黑。
探针会算平均像素,发现全黑就在 start 的返回里带一句提示,告诉你去系统设置里勾。
变化分刻度(0–255,同一套代码):
| 内容 | 分数 | |---|---| | 静止桌面 | 0.00(屏幕采集近似无损) | | 光标在静止画面上移动 | 0.7 | | 两张色调接近的照片切换 | 16~18 | | 滚网页 / 切窗口 | 30~42 | | 两张完全不同的照片切换 | 46~63 |
所以 cutAbs: 12 这个默认值的位置是:照片切换抓得住,光标和微小抖动碰不到。
---
src/
  capture.js    唯一 spawn ffmpeg 的地方,一根 rawvideo 管道
  binaries.js   找 ffmpeg(DSH 桌面版不进 PATH,所以不能写裸命令)
  cuts.js       逐帧变化分(64×36 HSV 网格)
  pipeline.js   唯一有状态的地方:帧 → 打分 → 切点/积分 → 留帧 → 档位 → pack → 出图
  tiers.js      档位(格子边长 1/k)与策略
  pack.js       DP 装箱:把 N 个不同大小的格子铺满画布
  sheet.js      合成 PNG(烧帧号、留缝)
  runner.js     采集管线 + 阻塞取图 + 节奏
  listen.js     听声音:扫 wav → 转写(宿主/本地 HTTP)→ 台词缓冲 → 挂到图上
  loop.js       常驻循环:有新图就唤醒模型
  index.js      工具注册与路由
examples/floating-chat/   悬浮窗(Tk)+ listen.py(抓回环、按静音断句)+ mic.py(麦克风)
debug/                    调试窗 + audio-check.mjs(手工验听声音,不在 npm 包里)
test/                     155 条测试
---
dupMin 那道粗筛)。它不保证给你的每一帧都"有新信息"。pace 里的间隔 —— 语音播报是串行的,更快只会排队。ddagrab / gdigrab)和 macOS(avfoundation)都实测过;x11grab 或 PipeWire,现在会直接报错,不假装能用)。
---
Apache License 2.0 —— 商用、闭源、再分发、改完再卖都可以,保留 LICENSE 与 NOTICE 即可。
examples/floating-chat/ 来自同作者的另一个项目 dsh-watch-together,两边现在是同一个协议,
不再有"这个目录 Apache、其余非商业"的分裂。
愿意打赏就扫上面那个码 —— 不打赏一样能用全部功能,没有任何东西锁在付费后面。
Copyright © 2026 SAOS-3624
→ →
 →
 →
 →
 →
 →
 →