
1
 →
liguodongiot/llm-action is an open-source project on GitHub, mainly written in HTML. 本项目旨在分享大模型相关技术原理以及实战经验(大模型工程化、大模型应用落地) It currently holds 25,082 stars and 0 forks with 0 open issues, and was last pushed on an unknown date (repository created unknown).
AI Homed tracks it on the AI Models & LLM Tools board.


下面汇总了我在大模型实践中训练相关的所有教程。从6B到65B,从全量微调到高效微调(LoRA,QLoRA,P-Tuning v2),再到RLHF(基于人工反馈的强化学习)。
| LLM | 预训练/SFT/RLHF... | 参数 | 教程 | 代码 |
| --------------------------- | ----------------------------- | -------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | ---------------------------------------------------------------------------------------- |
| Alpaca | full fine-turning | 7B | 从0到1复现斯坦福羊驼(Stanford Alpaca 7B) | 配套代码 |
| Alpaca(LLaMA) | LoRA | 7B~65B | 1.足够惊艳,使用Alpaca-Lora基于LLaMA(7B)二十分钟完成微调,效果比肩斯坦福羊驼
2. 使用 LoRA 技术对 LLaMA 65B 大模型进行微调及推理 | 配套代码 |
| BELLE(LLaMA/Bloom) | full fine-turning | 7B | 1.基于LLaMA-7B/Bloomz-7B1-mt复现开源中文对话大模型BELLE及GPTQ量化
2. BELLE(LLaMA-7B/Bloomz-7B1-mt)大模型使用GPTQ量化后推理性能测试 | N/A |
| ChatGLM | LoRA | 6B | 从0到1基于ChatGLM-6B使用LoRA进行参数高效微调 | 配套代码 |
| ChatGLM | full fine-turning/P-Tuning v2 | 6B | 使用DeepSpeed/P-Tuning v2对ChatGLM-6B进行微调 | 配套代码 |
| Vicuna(LLaMA) | full fine-turning | 7B | 大模型也内卷,Vicuna训练及推理指南,效果碾压斯坦福羊驼 | N/A |
| OPT | RLHF | 0.1B~66B | 1.一键式 RLHF 训练 DeepSpeed Chat(一):理论篇
2. 一键式 RLHF 训练 DeepSpeed Chat(二):实践篇 | 配套代码 |
| MiniGPT-4(LLaMA) | full fine-turning | 7B | 大杀器,多模态大模型MiniGPT-4入坑指南 | N/A |
| Chinese-LLaMA-Alpaca(LLaMA) | LoRA(预训练+微调) | 7B | 中文LLaMA&Alpaca大语言模型词表扩充+预训练+指令精调 | 配套代码 |
| LLaMA | QLoRA | 7B/65B | 高效微调技术QLoRA实战,基于LLaMA-65B微调仅需48G显存,真香 | 配套代码 |
| LLaMA | GaLore | 60M/7B | 突破内存瓶颈,使用 GaLore 一张4090消费级显卡也能预训练LLaMA-7B | 配套代码 |
对于普通大众来说,进行大模型的预训练或者全量微调遥不可及。由此,催生了各种参数高效微调技术,让科研人员或者普通开发者有机会尝试微调大模型。
因此,该技术值得我们进行深入分析其背后的机理,本系列大体分七篇文章进行讲解。
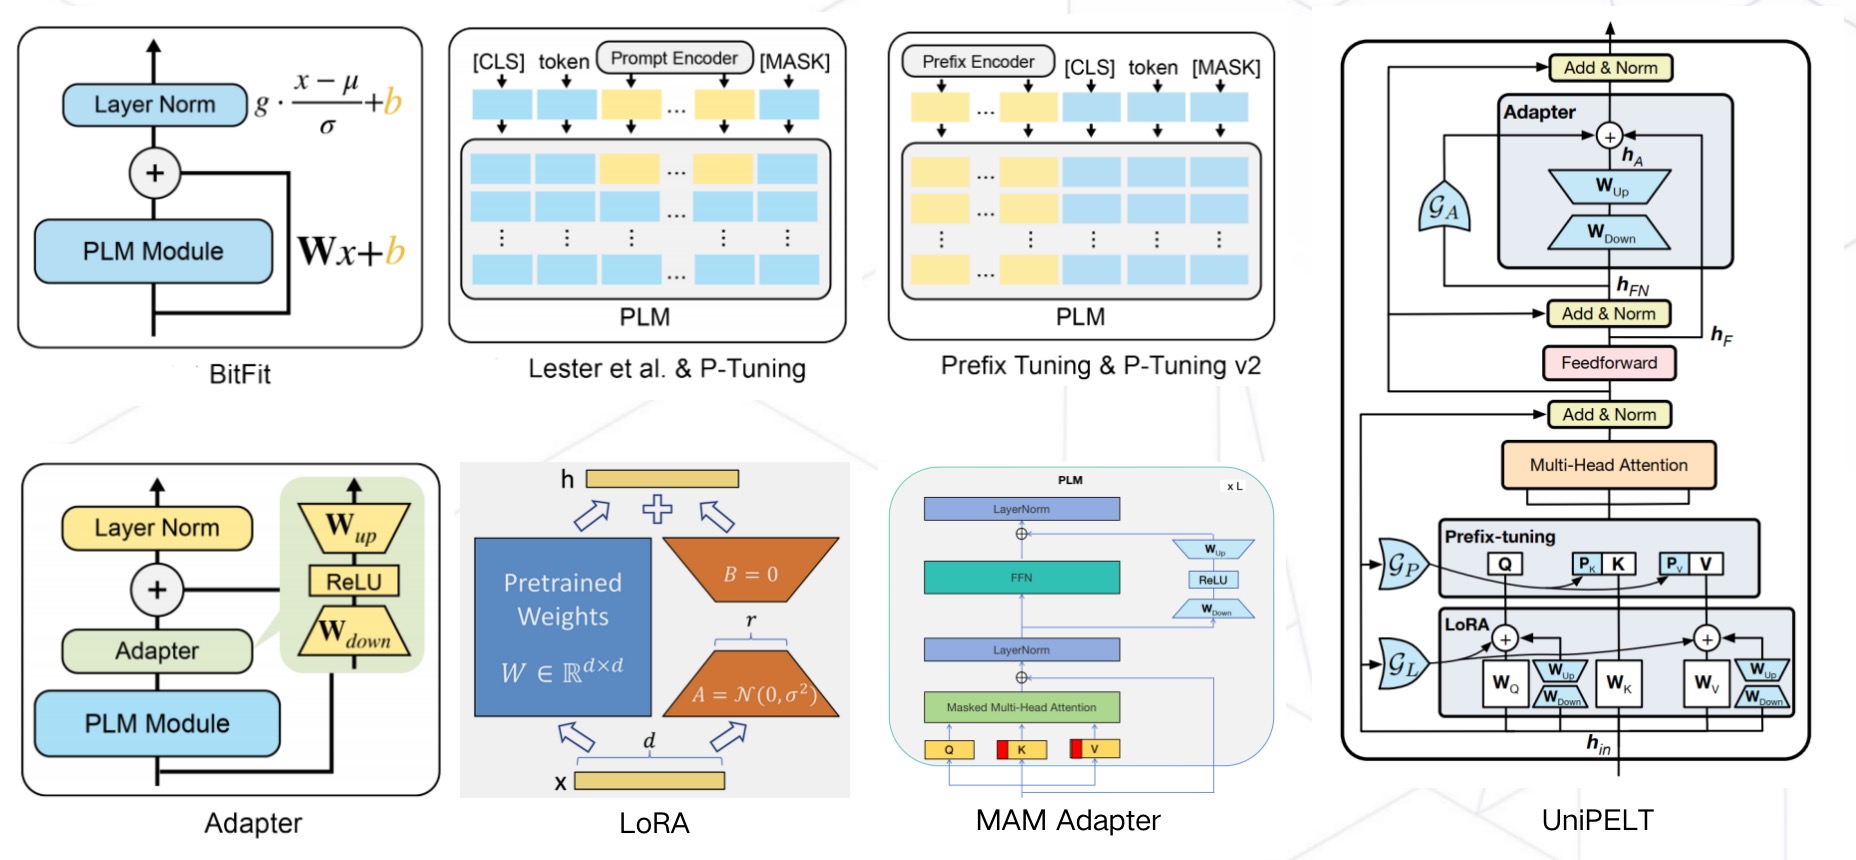
下面给大家分享大模型参数高效微调技术实战,该系列主要针对 HuggingFace PEFT 框架支持的一些高效微调技术进行讲解。
| 教程 | 代码 | 框架 | | ------------- | --------------- | --------------- | | 大模型参数高效微调技术实战(一)-PEFT概述及环境搭建 | N/A | HuggingFace PEFT | | 大模型参数高效微调技术实战(二)-Prompt Tuning | 配套代码 | HuggingFace PEFT | | 大模型参数高效微调技术实战(三)-P-Tuning | 配套代码 | HuggingFace PEFT | | 大模型参数高效微调技术实战(四)-Prefix Tuning / P-Tuning v2 | 配套代码 | HuggingFace PEFT | | 大模型参数高效微调技术实战(五)-LoRA | 配套代码 | HuggingFace PEFT | | 大模型参数高效微调技术实战(六)-IA3 | 配套代码 | HuggingFace PEFT | | 大模型微调实战(七)-基于LoRA微调多模态大模型 | 配套代码 | HuggingFace PEFT | | 大模型微调实战(八)-使用INT8/FP4/NF4微调大模型 | 配套代码 | PEFT、bitsandbytes |
近年来,随着Transformer、MOE架构的提出,使得深度学习模型轻松突破上万亿规模参数,传统的单机单卡模式已经无法满足超大模型进行训练的要求。因此,我们需要基于单机多卡、甚至是多机多卡进行分布式大模型的训练。
而利用AI集群,使深度学习算法更好地从大量数据中高效地训练出性能优良的大模型是分布式机器学习的首要目标。为了实现该目标,一般需要根据硬件资源与数据/模型规模的匹配情况,考虑对计算任务、训练数据和模型进行划分,从而进行分布式训练。因此,分布式训练相关技术值得我们进行深入分析其背后的机理。
下面主要对大模型进行分布式训练的并行技术进行讲解,本系列大体分九篇文章进行讲解。
待更新...
迷你LLM推理引擎(非常适合源码学习):
生产级LLM推理引擎:
其他推理引擎:近年来,随着Transformer、MOE架构的提出,使得深度学习模型轻松突破上万亿规模参数,从而导致模型变得越来越大,因此,我们需要一些大模型压缩技术来降低模型部署的成本,并提升模型的推理性能。 模型压缩主要分为如下几类:
本系列将针对一些常见大模型量化方案(GPTQ、LLM.int8()、SmoothQuant、AWQ等)进行讲述。
目前,大多数针对大模型模型的压缩技术都专注于模型量化领域,即降低单个权重的数值表示的精度。另一种模型压缩方法模型剪枝的研究相对较少,即删除网络元素,包括从单个权重(非结构化剪枝)到更高粒度的组件,如权重矩阵的整行/列(结构化剪枝)。
本系列将针对一些常见大模型稀疏化方案(LLM-Pruner、SliceGPT、SparseGPT、Wanda等)进行讲述。
结构化剪枝:
非结构化剪枝:
使学生模型学习教师模型(LLM)所拥有的常见知识,如输出分布和特征信息,这种方法类似于传统的KD。
不仅仅是将LLM的常见知识转移到学生模型中,还涵盖了蒸馏它们独特的涌现能力。具体来说,EA-based KD又分为了上下文学习(ICL)、思维链(CoT)和指令跟随(IF)。
In-Context Learning:
低秩分解旨在通过将给定的权重矩阵分解成两个或多个较小维度的矩阵,从而对其进行近似。低秩分解背后的核心思想是找到一个大的权重矩阵W的分解,得到两个矩阵U和V,使得W≈U V,其中U是一个m×k矩阵,V是一个k×n矩阵,其中k远小于m和n。U和V的乘积近似于原始的权重矩阵,从而大幅减少了参数数量和计算开销。
在LLM研究的模型压缩领域,研究人员通常将多种技术与低秩分解相结合,包括修剪、量化等。
Coding:
LLM Data Engineering
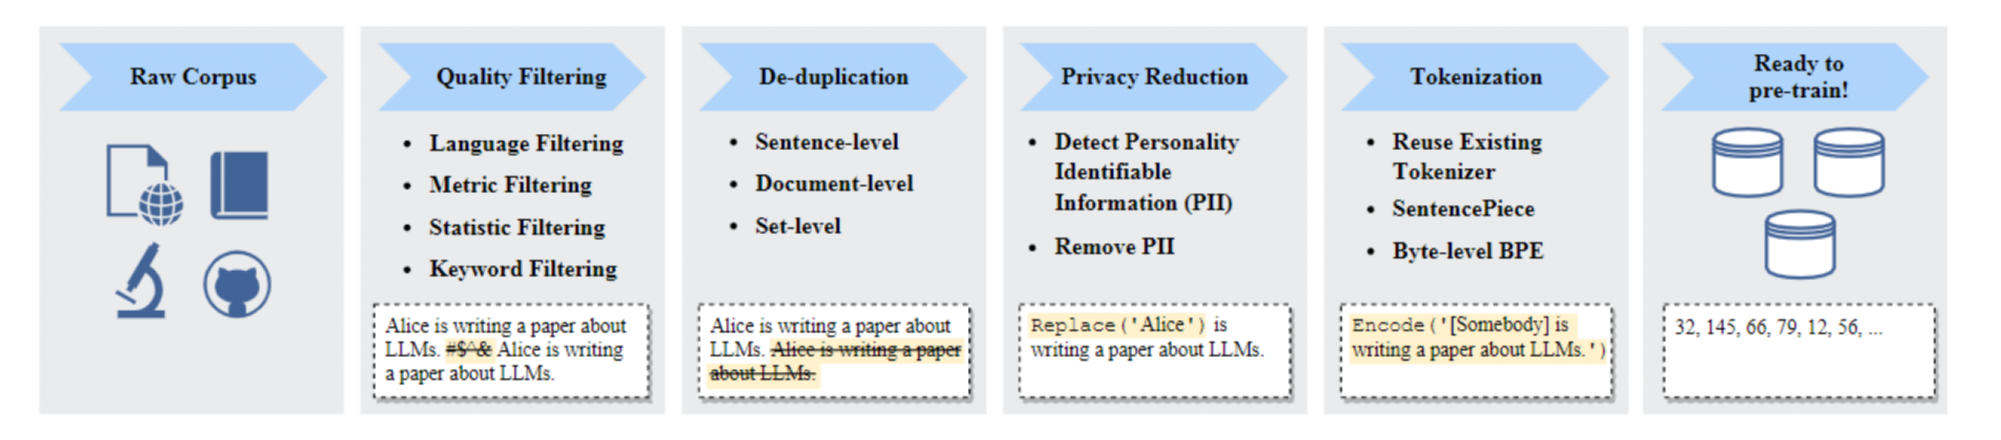
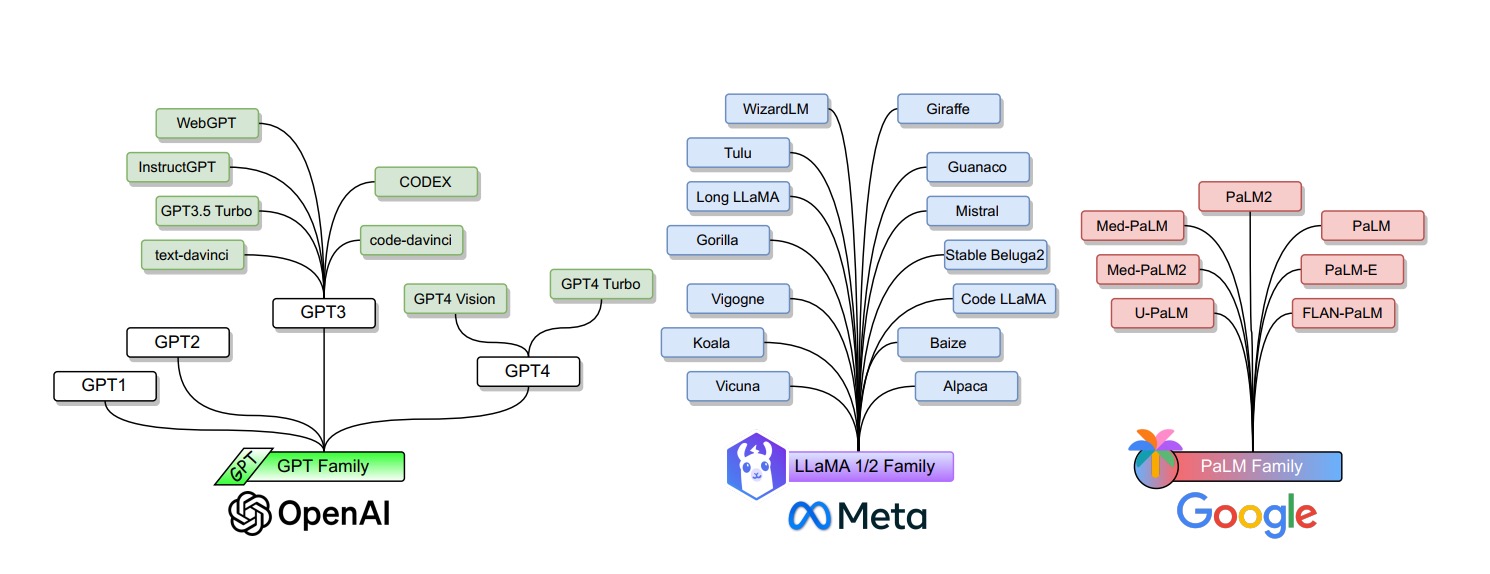
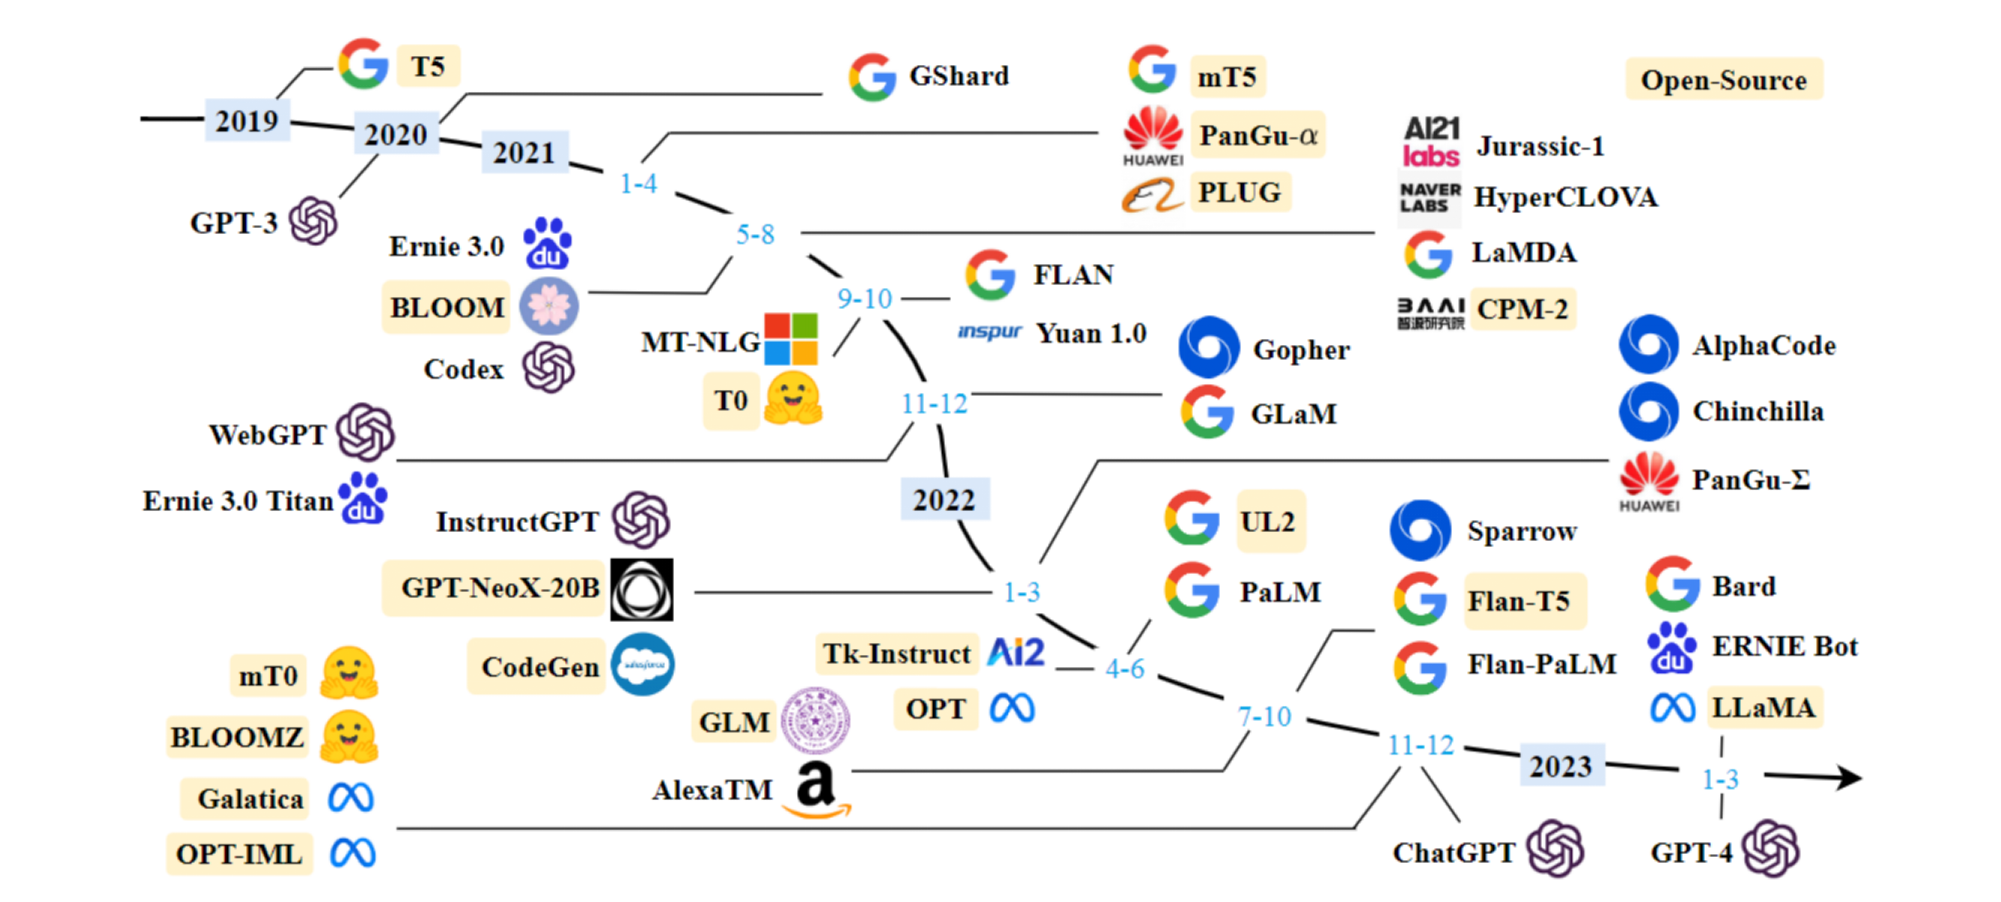
大模型是基座,要想让其变成一款产品,我们还需要一些其他相关的技术,比如:向量数据库(Pinecone、Milvus、Vespa、Weaviate),LangChain等。
Harness:
AI Assistant:→ →
 →
 →
 →
 →
 →
 →