1
 →

From Chain-of-Thought prompting to OpenAI o1 and DeepSeek-R1 🍓
atfortes/Awesome-LLM-Reasoning is an open-source project on GitHub, mainly written in several languages. From Chain-of-Thought prompting to OpenAI o1 and DeepSeek-R1 🍓 It currently holds 3,685 stars and 213 forks with 0 open issues, and was last pushed on an unknown date (repository created unknown).
AI Homed tracks it on the AI Prompt Engineering board.
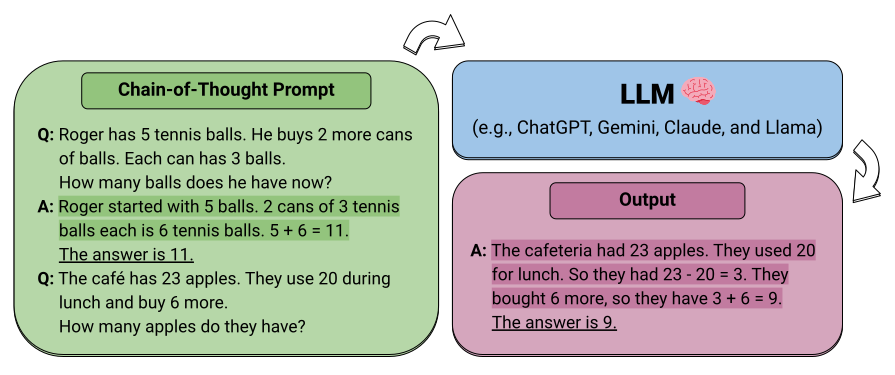
Curated collection of papers and resources on how to unlock the reasoning ability of LLMs and MLLMs.
If you would like to test the symbolic reasoning ability of LLMs, take a look at: LLMSymbolicReasoningBench 😄
1. Multimodal Chain-of-Thought Reasoning: A Comprehensive Survey. [code]
Yaoting Wang, Shengqiong Wu, Yuecheng Zhang, William Wang, Ziwei Liu, Jiebo Luo, Hao Fei. Preprint'25
2. Recent Advances in Large Language Model Benchmarks Against Data Contamination: From Static to Dynamic Evaluation. [code]
Simin Chen, Yiming Chen, Zexin Li, Yifan Jiang, Zhongwei Wan, Yixin He, Dezhi Ran, Tianle Gu, Haizhou Li, Tao Xie, Baishakhi Ray. Preprint'25
1. Attention Heads of Large Language Models: A Survey. [code]
Zifan Zheng, Yezhaohui Wang, Yuxin Huang, Shichao Song, Bo Tang, Feiyu Xiong, Zhiyu Li. Preprint'24
1. Internal Consistency and Self-Feedback in Large Language Models: A Survey. [code]
Xun Liang, Shichao Song, Zifan Zheng, Hanyu Wang, Qingchen Yu, Xunkai Li, Rong-Hua Li, Feiyu Xiong, Zhiyu Li. Preprint'24
1. Puzzle Solving using Reasoning of Large Language Models: A Survey. [code]
Panagiotis Giadikiaroglou, Maria Lymperaiou, Giorgos Filandrianos, Giorgos Stamou. Preprint'24
1. Large Language Models for Mathematical Reasoning: Progresses and Challenges.
Janice Ahn, Rishu Verma, Renze Lou, Di Liu, Rui Zhang, Wenpeng Yin. ACL'24
1. Towards Reasoning in Large Language Models: A Survey. [code]
Jie Huang, Kevin Chen-Chuan Chang. ACL'23 Findings
1. Reasoning with Language Model Prompting: A Survey. [code]
Shuofei Qiao, Yixin Ou, Ningyu Zhang, Xiang Chen, Yunzhi Yao, Shumin Deng, Chuanqi Tan, Fei Huang, Huajun Chen. ACL'23
1. New Trends for Modern Machine Translation with Large Reasoning Models.
Sinuo Liu, Chenyang Lyu, Minghao Wu, Longyue Wang, Weihua Luo, Kaifu Zhang, Zifu Shang. Preprint'25
1. Are Your LLMs Capable of Stable Reasoning? [code]
Junnan Liu, Hongwei Liu, Linchen Xiao, Ziyi Wang, Kuikun Liu, Songyang Gao, Wenwei Zhang, Songyang Zhang, Kai Chen. Preprint'24
1. From Medprompt to o1: Exploration of Run-Time Strategies for Medical Challenge Problems and Beyond.
Harsha Nori, Naoto Usuyama, Nicholas King, Scott Mayer McKinney, Xavier Fernandes, Sheng Zhang, Eric Horvitz. Preprint'24
1. To CoT or not to CoT? Chain-of-thought helps mainly on math and symbolic reasoning.
Zayne Sprague, Fangcong Yin, Juan Diego Rodriguez, Dongwei Jiang, Manya Wadhwa, Prasann Singhal, Xinyu Zhao, Xi Ye, Kyle Mahowald, Greg Durrett. Preprint'24
1. Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers.
Chenglei Si, Diyi Yang, Tatsunori Hashimoto. Preprint'24
1. A Peek into Token Bias: Large Language Models Are Not Yet Genuine Reasoners. [code]
Bowen Jiang, Yangxinyu Xie, Zhuoqun Hao, Xiaomeng Wang, Tanwi Mallick, Weijie J. Su, Camillo J. Taylor, Dan Roth. EMNLP'24
1. Iteration Head: A Mechanistic Study of Chain-of-Thought
Vivien Cabannes, Charles Arnal, Wassim Bouaziz, Alice Yang, Francois Charton, Julia Kempe. NeurIPS'24
1. Do Large Language Models Latently Perform Multi-Hop Reasoning?
Sohee Yang, Elena Gribovskaya, Nora Kassner, Mor Geva, Sebastian Riedel. ACL'24
1. Premise Order Matters in Reasoning with Large Language Models.
Xinyun Chen, Ryan A. Chi, Xuezhi Wang, Denny Zhou. ICML'24
1. The Impact of Reasoning Step Length on Large Language Models.
Mingyu Jin, Qinkai Yu, Dong Shu, Haiyan Zhao, Wenyue Hua, Yanda Meng, Yongfeng Zhang, Mengnan Du. ACL'24 Findings
1. Large Language Models Cannot Self-Correct Reasoning Yet.
Jie Huang, Xinyun Chen, Swaroop Mishra, Huaixiu Steven Zheng, Adams Wei Yu, Xinying Song, Denny Zhou. ICLR'24
1. At Which Training Stage Does Code Data Help LLM Reasoning?
Yingwei Ma, Yue Liu, Yue Yu, Yuanliang Zhang, Yu Jiang, Changjian Wang, Shanshan Li. ICLR'24
1. Measuring Faithfulness in Chain-of-Thought Reasoning.
Tamera Lanham, Anna Chen, Ansh Radhakrishnan, Benoit Steiner, Carson Denison, Danny Hernandez, Dustin Li, Esin Durmus, Evan Hubinger, Jackson Kernion, Kamilė Lukošiūtė, Karina Nguyen, Newton Cheng, Nicholas Joseph, Nicholas Schiefer, Oliver Rausch, Robin Larson, Sam McCandlish, Sandipan Kundu, Saurav Kadavath, Shannon Yang, Thomas Henighan, Timothy Maxwell, Timothy Telleen-Lawton, Tristan Hume, Zac Hatfield-Dodds, Jared Kaplan, Jan Brauner, Samuel R. Bowman, Ethan Perez. Preprint'23
1. Faith and Fate: Limits of Transformers on Compositionality.
Nouha Dziri, Ximing Lu, Melanie Sclar, Xiang Lorraine Li, Liwei Jiang, Bill Yuchen Lin, Peter West, Chandra Bhagavatula, Ronan Le Bras, Jena D. Hwang, Soumya Sanyal, Sean Welleck, Xiang Ren, Allyson Ettinger, Zaid Harchaoui, Yejin Choi. NeurIPS'23
1. Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting. [code]
Miles Turpin, Julian Michael, Ethan Perez, Samuel R. Bowman. NeurIPS'23
Yejin Bang, Samuel Cahyawijaya, Nayeon Lee, Wenliang Dai, Dan Su, Bryan Wilie, Holy Lovenia, Ziwei Ji, Tiezheng Yu, Willy Chung, Quyet V. Do, Yan Xu, Pascale Fung. AACL'23
1. Large Language Models Can Be Easily Distracted by Irrelevant Context.
Freda Shi, Xinyun Chen, Kanishka Misra, Nathan Scales, David Dohan, Ed Chi, Nathanael Schärli, Denny Zhou. ICML'23 1. On Second Thought, Let's Not Think Step by Step! Bias and Toxicity in Zero-Shot Reasoning.
Omar Shaikh, Hongxin Zhang, William Held, Michael Bernstein, Diyi Yang. ACL'23
1. Towards Understanding Chain-of-Thought Prompting: An Empirical Study of What Matters. [code]
Boshi Wang, Sewon Min, Xiang Deng, Jiaming Shen, You Wu, Luke Zettlemoyer, Huan Sun. ACL'23
1. Challenging BIG-Bench Tasks and Whether Chain-of-Thought Can Solve Them. [code]
Mirac Suzgun, Nathan Scales, Nathanael Schärli, Sebastian Gehrmann, Yi Tay, Hyung Won Chung, Aakanksha Chowdhery, Quoc V. Le, Ed H. Chi, Denny Zhou, Jason Wei. ACL'23 Findings
1. Emergent Abilities of Large Language Models. [blog]
Jason Wei, Yi Tay, Rishi Bommasani, Colin Raffel, Barret Zoph, Sebastian Borgeaud, Dani Yogatama, Maarten Bosma, Denny Zhou, Donald Metzler, Ed H. Chi, Tatsunori Hashimoto, Oriol Vinyals, Percy Liang, Jeff Dean, William Fedus. TMLR'22
1. Can language models learn from explanations in context?
Andrew K. Lampinen, Ishita Dasgupta, Stephanie C. Y. Chan, Kory Matthewson, Michael Henry Tessler, Antonia Creswell, James L. McClelland, Jane X. Wang, Felix Hill. EMNLP'22
1. JudgeLRM: Large Reasoning Models as a Judge.
Nuo Chen, Zhiyuan Hu, Qingyun Zou, Jiaying Wu, Qian Wang, Bryan Hooi, Bingsheng He. Preprint'25 1. Dynamic Benchmarking of Reasoning Capabilities in Code Large Language Models Under Data Contamination. [code]
Simin Chen, Pranav Pusarla, Baishakhi Ray. ICML'25
1. CRANE: Reasoning with constrained LLM generation.
Debangshu Banerjee, Tarun Suresh, Shubham Ugare, Sasa Misailovic, Gagandeep Singh. ICML'25
1. Sketch-of-Thought: Efficient LLM Reasoning with Adaptive Cognitive-Inspired Sketching. [code]
Simon A. Aytes, Jinheon Baek, Sung Ju Hwang. Preprint'25
1. Self-rewarding correction for mathematical reasoning.
Wei Xiong, Hanning Zhang, Chenlu Ye, Lichang Chen, Nan Jiang, Tong Zhang. Preprint'25
1. Competitive Programming with Large Reasoning Models.
OpenAI: Ahmed El-Kishky, Alexander Wei, Andre Saraiva, Borys Minaiev, Daniel Selsam, David Dohan, Francis Song, Hunter Lightman, Ignasi Clavera, Jakub Pachocki, Jerry Tworek, Lorenz Kuhn, Lukasz Kaiser, Mark Chen, Max Schwarzer, Mostafa Rohaninejad, Nat McAleese, o3 contributors, Oleg Mürk, Rhythm Garg, Rui Shu, Szymon Sidor, Vineet Kosaraju, Wenda Zhou. Preprint'25
1. s1: Simple test-time scaling.
Niklas Muennighoff, Zitong Yang, Weijia Shi, Xiang Lisa Li, Li Fei-Fei, Hannaneh Hajishirzi, Luke Zettlemoyer, Percy Liang, Emmanuel Candès, Tatsunori Hashimoto. Preprint'25
1. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. [project]
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, Xiaokang Zhang, Xingkai Yu, Yu Wu, Z.F. Wu, Zhibin Gou, Zhihong Shao, Zhuoshu Li, Ziyi Gao, et al. Preprint'25
1. Towards System 2 Reasoning in LLMs: Learning How to Think With Meta Chain-of-Thought.
Violet Xiang, Charlie Snell, Kanishk Gandhi, Alon Albalak, Anikait Singh, Chase Blagden, Duy Phung, Rafael Rafailov, Nathan Lile, Dakota Mahan, Louis Castricato, Jan-Philipp Franken, Nick Haber, Chelsea Finn. Preprint'25
1. HuatuoGPT-o1, Towards Medical Complex Reasoning with LLMs [code]
Junying Chen, Zhenyang Cai, Ke Ji, Xidong Wang, Wanlong Liu, Rongsheng Wang, Jianye Hou, Benyou Wang. Preprint'24
1. PPM: Automated Generation of Diverse Programming Problems for Benchmarking Code Generation Models [code] Simin Chen, XiaoNing Feng, Xiaohong Han, Cong Liu, Wei Yang FSE'24
1. DRT-o1: Optimized Deep Reasoning Translation via Long Chain-of-Thought. [code]
Jiaan Wang, Fandong Meng, Yunlong Liang, Jie Zhou. Preprint'24
1. MALT: Improving Reasoning with Multi-Agent LLM Training.
Sumeet Ramesh Motwani, Chandler Smith, Rocktim Jyoti Das, Markian Rybchuk, Philip H. S. Torr, Ivan Laptev, Fabio Pizzati, Ronald Clark, Christian Schroeder de Witt. Preprint'24
1. SmartAgent: Chain-of-User-Thought for Embodied Personalized Agent in Cyber World.
Jiaqi Zhang, Chen Gao, Liyuan Zhang, Yong Li, Hongzhi Yin. Preprint'24
1. Marco-o1: Towards Open Reasoning Models for Open-Ended Solutions. [code] [model]
Yu Zhao, Huifeng Yin, Bo Zeng, Hao Wang, Tianqi Shi, Chenyang Lyu, Longyue Wang, Weihua Luo, Kaifu Zhang. Preprint'24
Kuofeng Gao, Huanqia Cai, Qingyao Shuai, Dihong Gong, Zhifeng Li. Preprint'24
1. Deliberate Reasoning for LLMs as Structure-aware Planning with Accurate World Model. [code]
Siheng Xiong, Ali Payani, Yuan Yang, Faramarz Fekri. Preprint'24
1. Interpretable Contrastive Monte Carlo Tree Search Reasoning.
Zitian Gao, Boye Niu, Xuzheng He, Haotian Xu, Hongzhang Liu, Aiwei Liu, Xuming Hu, Lijie Wen. Preprint'24
1. Training Language Models to Self-Correct via Reinforcement Learning.
Aviral Kumar, Vincent Zhuang, Rishabh Agarwal, Yi Su, JD Co-Reyes, Avi Singh, Kate Baumli, Shariq Iqbal, Colton Bishop, Rebecca Roelofs, Lei M. Zhang, Kay McKinney, Disha Shrivastava, Cosmin Paduraru, George Tucker, Doina Precup, Feryal Behbahani, Aleksandra Faust. Preprint'24
1. OpenAI o1.
Open AI Team. Technical Report'24
1. Agent Q: Advanced Reasoning and Learning for Autonomous AI Agents.
Pranav Putta, Edmund Mills, Naman Garg, Sumeet Motwani, Chelsea Finn, Divyansh Garg, Rafael Rafailov. Preprint'24
1. DotaMath: Decomposition of Thought with Code Assistance and Self-correction for Mathematical Reasoning. [code]
Chengpeng Li, Guanting Dong, Mingfeng Xue, Ru Peng, Xiang Wang, Dayiheng Liu. Preprint'24
1. LLM-ARC: Enhancing LLMs with an Automated Reasoning Critic.
Aditya Kalyanpur, Kailash Saravanakumar, Victor Barres, Jennifer Chu-Carroll, David Melville, David Ferrucci. Preprint'24
1. **Q\*: Improving Multi-step Reasoning for LLMs with Deliberative Planning.**
Chaojie Wang, Yanchen Deng, Zhiyi Lv, Shuicheng Yan, An Bo. Preprint'24
1. Buffer of Thoughts: Thought-Augmented Reasoning with Large Language Models. [code]
Ling Yang, Zhaochen Yu, Tianjun Zhang, Shiyi Cao, Minkai Xu, Wentao Zhang, Joseph E. Gonzalez, Bin Cui. Preprint'24
1. Toward Self-Improvement of LLMs via Imagination, Searching, and Criticizing.
Ye Tian, Baolin Peng, Linfeng Song, Lifeng Jin, Dian Yu, Haitao Mi, Dong Yu. Preprint'24
1. Self-playing Adversarial Language Game Enhances LLM Reasoning.
Pengyu Cheng, Tianhao Hu, Han Xu, Zhisong Zhang, Yong Dai, Lei Han, Nan Du. Preprint'24
1. Evaluating Mathematical Reasoning Beyond Accuracy.
Shijie Xia, Xuefeng Li, Yixin Liu, Tongshuang Wu, Pengfei Liu. Preprint'24
1. Advancing LLM Reasoning Generalists with Preference Trees.
Lifan Yuan, Ganqu Cui, Hanbin Wang, Ning Ding, Xingyao Wang, Jia Deng, Boji Shan, Huimin Chen, Ruobing Xie, Yankai Lin, Zhenghao Liu, Bowen Zhou, Hao Peng, Zhiyuan Liu, Maosong Sun. Preprint'24
1. LLM3: Large Language Model-based Task and Motion Planning with Motion Failure Reasoning. [code]
Shu Wang, Muzhi Han, Ziyuan Jiao, Zeyu Zhang, Ying Nian Wu, Song-Chun Zhu, Hangxin Liu. IROS'24
1. Quiet-STaR: Language Models Can Teach Themselves to Think Before Speaking.
Eric Zelikman, Georges Harik, Yijia Shao, Varuna Jayasiri, Nick Haber, Noah D. Goodman. Preprint'24
1. GLoRe: When, Where, and How to Improve LLM Reasoning via Global and Local Refinements.
Alex Havrilla, Sharath Raparthy, Christoforus Nalmpantis, Jane Dwivedi-Yu, Maksym Zhuravinskyi, Eric Hambro, Roberta Railneau. ICML'24
1. Chain-of-Thought Reasoning Without Prompting.
Xuezhi Wang, Denny Zhou. Preprint'24
1. V-STaR: Training Verifiers for Self-Taught Reasoners.
Arian Hosseini, Xingdi Yuan, Nikolay Malkin, Aaron Courville, Alessandro Sordoni, Rishabh Agarwal. Preprint'24
1. InternLM-Math: Open Math Large Language Models Toward Verifiable Reasoning.
Huaiyuan Ying, Shuo Zhang, Linyang Li, Zhejian Zhou, Yunfan Shao, Zhaoye Fei, Yichuan Ma, Jiawei Hong, Kuikun Liu, Ziyi Wang, Yudong Wang, Zijian Wu, Shuaibin Li, Fengzhe Zhou, Hongwei Liu, Songyang Zhang, Wenwei Zhang, Hang Yan, Xipeng Qiu, Jiayu Wang, Kai Chen, Dahua Lin. Preprint'24
1. Self-Discover: Large Language Models Self-Compose Reasoning Structures.
Pei Zhou, Jay Pujara, Xiang Ren, Xinyun Chen, Heng-Tze Cheng, Quoc V. Le, Ed H. Chi, Denny Zhou, Swaroop Mishra, Huaixiu Steven Zheng. Preprint'24
1. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models.
Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, Y.K. Li, Y. Wu, Daya Guo. Preprint'24
1. K-Level Reasoning with Large Language Models.
Yadong Zhang, Shaoguang Mao, Tao Ge, Xun Wang, Yan Xia, Man Lan, Furu Wei. Preprint'24
1. Efficient Tool Use with Chain-of-Abstraction Reasoning.
Silin Gao, Jane Dwivedi-Yu, Ping Yu, Xiaoqing Ellen Tan, Ramakanth Pasunuru, Olga Golovneva, Koustuv Sinha, Asli Celikyilmaz, Antoine Bosselut, Tianlu Wang. Preprint'24
1. Teaching Language Models to Self-Improve through Interactive Demonstrations.
Xiao Yu, Baolin Peng, Michel Galley, Jianfeng Gao, Zhou Yu. NAACL'24
1. Enhancing Zero-Shot Chain-of-Thought Reasoning in Large Language Models through Logic. [code]
Xufeng Zhao, Mengdi Li, Wenhao Lu, Cornelius Weber, Jae Hee Lee, Kun Chu, Stefan Wermter. COLING'24
1. Chain-of-Verification Reduces Hallucination in Large Language Models.
Shehzaad Dhuliawala, Mojtaba Komeili, Jing Xu, Roberta Raileanu, Xian Li, Asli Celikyilmaz, Jason Weston. ACL'24 Findings
1. Skeleton-of-Thought: Large Language Models Can Do Parallel Decoding.
Xuefei Ning, Zinan Lin, Zixuan Zhou, Huazhong Yang, Yu Wang. ICLR'24
1. Question Decomposition Improves the Faithfulness of Model-Generated Reasoning. [code]
Ansh Radhakrishnan, Karina Nguyen, Anna Chen, Carol Chen, Carson Denison, Danny Hernandez, Esin Durmus, Evan Hubinger, Jackson Kernion, Kamilė Lukošiūtė, Newton Cheng, Nicholas Joseph, Nicholas Schiefer, Oliver Rausch, Sam McCandlish, Sheer El Showk, Tamera Lanham, Tim Maxwell, Venkatesa Chandrasekaran, Zac Hatfield-Dodds, Jared Kaplan, Jan Brauner, Samuel R. Bowman, Ethan Perez. Preprint'23
Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever, Karl Cobbe. ICLR'24
1. REFINER: Reasoning Feedback on Intermediate Representations. [project] [code]
Debjit Paul, Mete Ismayilzada, Maxime Peyrard, Beatriz Borges, Antoine Bosselut, Robert West, Boi Faltings. EACL'24
1. Active Prompting with Chain-of-Thought for Large Language Models. [code]
Shizhe Diao, Pengcheng Wang, Yong Lin, Tong Zhang. ACL'24
1. Language Models as Inductive Reasoners.
Zonglin Yang, Li Dong, Xinya Du, Hao Cheng, Erik Cambria, Xiaodong Liu, Jianfeng Gao, Furu Wei. EACL'24
1. Boosting LLM Reasoning: Push the Limits of Few-shot Learning with Reinforced In-Context Pruning.
Xijie Huang, Li Lyna Zhang, Kwang-Ting Cheng, Mao Yang. Preprint'23
1. **Logic-LM: Empowering Large Language Models with Symbolic Solvers for Faithful Logical Reasoning.
→ →
 →
 →
 →
 →
 →
 →